自分のWebサイトに掲載した記事や画像を、ChatGPTなどの生成AIの学習に使われたくないと考えるサイト運営者もいらっしゃるでしょう。
その対策の一つが、robots.txtを使ってAI学習用クローラー(Webページを自動収集するプログラム)のアクセスを制限する方法です。ただし、設定する対象によってはAI検索での露出にも影響するため、用途の違いを理解しておく必要があります。
この記事では、主要AI事業者の設定例からWordPressでの編集方法、検索流入への影響、2026年10月に発表された新しい共通指定まで解説します。
robots.txtでAI学習を拒否することはできる?
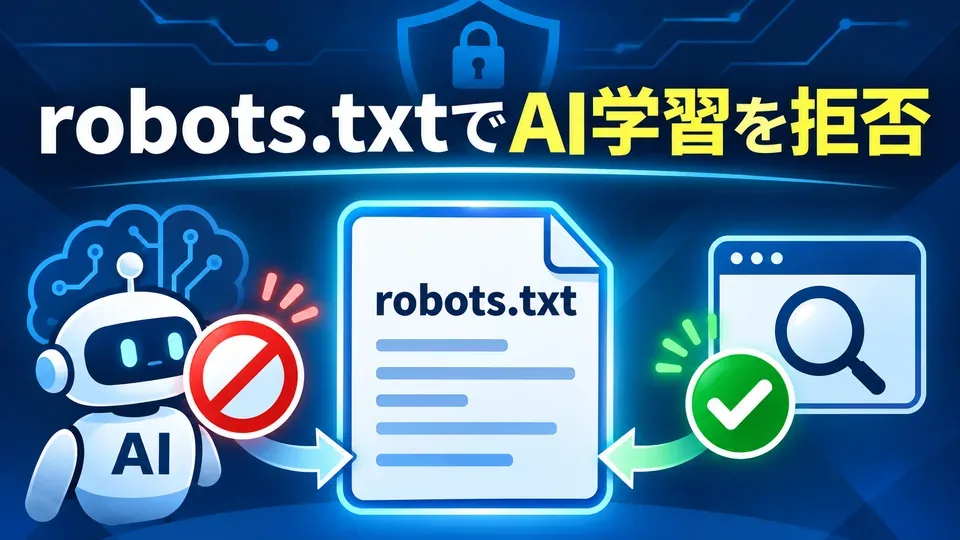
結論として、robots.txtに学習用クローラーの拒否ルールを記載することで、対応するAI事業者へコンテンツ収集を拒否する意思を伝えられます。
robots.txtは、Webサイトの管理者がクローラーにアクセス可能な範囲を知らせるためのテキストファイルです。一般的には検索エンジンの巡回制御に利用されていますが、AI事業者も学習用のアクセス制御に対応しています。
例えばOpenAIは「GPTBot」、Anthropicは「ClaudeBot」という学習関連のクローラーを公開しています。これらを個別に指定すれば、検索エンジン全体を遮断せずに学習用の収集を制限できます。
ただし、robots.txtはアクセスを物理的に禁止するセキュリティ機能ではありません。ルールを守るかどうかはクローラー側の実装に依存します。すでに取得されたデータを削除する仕組みでもないため、学習への利用を完全に防げるとは限りません。
AI学習の拒否とAI検索の拒否は別の設定
AI事業者によっては、モデルの学習用と検索結果の生成用で異なるクローラーを使用しています。
| 目的 | 代表的なクローラー | 主な役割 |
|---|---|---|
| AIモデルの学習 | GPTBot、ClaudeBot | モデルの開発・学習に利用する可能性のあるWeb情報の収集 |
| AI検索 | OAI-SearchBot、Claude-SearchBot | AI検索の回答や検索品質に関係する情報の取得 |
| 利用者の要求による取得 | ChatGPT-User、Claude-User | ユーザーからの要求に応じたページの取得 |
AI検索からのアクセスを維持したい場合は、学習用と検索用を区別して設定することが重要です。OpenAIとAnthropicは、それぞれの用途に対応するクローラーを公式資料で案内しています。
robots.txtの基本的な役割や書き方、SEO(検索エンジン最適化)への影響について詳しく知りたい方は、robots.txtとは?役割・用途・書き方とSEOで注意したいポイントもあわせてご覧ください。
robots.txtでAI学習を拒否する書き方
主要なAI学習用クローラーへのアクセスを拒否するには、以下の設定例を利用できます。
既存のrobots.txtがある場合は、現在の設定を削除せず、必要なルールを追加する方法を基本としてください。
GPTBot・ClaudeBot・Google-Extendedを拒否する設定例
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /
各設定の意味は次のとおりです。
| 指定する名前 | 事業者 | 拒否する対象 |
|---|---|---|
| GPTBot | OpenAI | AIモデルの学習に利用される可能性があるコンテンツの収集 |
| ClaudeBot | Anthropic | Claudeのモデル開発・学習に関係する収集 |
| Google-Extended | Gemini関連の学習や一部のグラウンディング(回答を外部情報に基づかせる処理)への利用 |
User-agentは対象となるクローラーを指定する項目です。Disallow: /は、対象クローラーにサイト全体へのアクセスを許可しないことを示します。
Google-Extendedは通常のGooglebotとは異なる制御対象です。Google検索の掲載やランキングへの影響とは分けて考える必要があります。一方、Geminiアプリなどでの情報利用に影響する可能性があるため、GoogleのAIサービスからの露出も重視する場合は設定を検討してください。
特定のディレクトリだけ拒否する方法
サイト全体ではなく、一部のコンテンツだけを対象にすることも可能です。
例えば、/premium/以下へのGPTBotのアクセスを拒否する場合は次のように記載します。
User-agent: GPTBot
Disallow: /premium/
この例では、指定したパスから始まるURLが拒否対象となります。通常の記事は公開したまま、特定の領域だけ制限したい場合に利用できます。
ただし、robots.txtはアクセス制御や認証の代わりにはなりません。非公開情報や有料会員限定の内容を保護する場合は、ログイン認証などの実際のアクセス制限を使用してください。
WordPressでrobots.txtを編集する方法
WordPressでは、サーバー上のrobots.txtを編集する方法があります。サイトの構成や利用中のプラグインによっては、管理画面から編集できる場合もあります。
設定を変更する前に、現在のrobots.txtを保存しておくと、問題が起きた際に元の状態へ戻しやすくなります。
STEP1:現在のrobots.txtを確認する
まず、ブラウザで自分のドメインの末尾に/robots.txtを付けてアクセスしてください。
例えばWebクラスの場合、確認先は次のURLです。
https://webcras.com/robots.txtrobots.txtが表示される場合は、既存のルールを確認します。表示されない場合でも、WordPressやサーバー側の設定によって管理方法が異なるため、すぐに新規ファイルを作る必要があるとは限りません。
STEP2:サーバー側でrobots.txtを編集する
サーバーのファイルマネージャーやFTP(サーバーとファイルを送受信する仕組み)を利用できる場合は、対象サイトの公開ルートにあるrobots.txtを編集できます。
- 利用中のレンタルサーバーの管理画面へログインします。
- 対象ドメインの公開ディレクトリを開きます。
- 既存のrobots.txtをバックアップします。
- 学習用クローラーの拒否ルールを追加して保存します。
robots.txtの設置場所は、Webサイトのルートディレクトリ(公開URLの最上位に対応する場所)です。Googleの公式資料でも、対象ホストのルートに配置する必要があると説明されています。
サーバーによって公開ディレクトリの名称は異なるため、別サイトのフォルダーを編集しないよう注意してください。
STEP3:WordPressのSEOプラグインから編集する場合
一部のSEOプラグインにはrobots.txtの編集機能があります。ただし、すべてのプラグインで対応しているわけではありません。
管理画面にrobots.txtの編集機能がある場合は、その機能を利用する方法もあります。物理ファイルが存在すると仮想robots.txtの編集機能が利用できないなど、環境ごとの違いにも注意が必要です。
複数の方法で同時にrobots.txtを管理すると、どの設定が実際に配信されているのか分かりにくくなります。最終的にはブラウザで公開中のrobots.txtを確認してください。
STEP4:設定が反映されているか確認する
保存後は、もう一度https://自分のドメイン/robots.txtへアクセスします。
追加したUser-agentとDisallowが表示されていれば、公開されているファイルへの反映を確認できます。
ただし、ファイルが表示されることと、各AI事業者が実際にアクセスを停止したことは同じではありません。クローラー側が更新されたルールを取得するまで時間がかかる場合もあります。
より詳しく調べる場合は、サーバーのアクセスログ(アクセス元や要求内容の記録)で該当するクローラーのアクセス状況を確認する方法があります。ただし、User-agentの文字列は偽装できるため、名称だけでアクセス元の正当性を断定しないでください。
AI学習を拒否するとGoogle検索やChatGPT検索に影響する?
AI学習を拒否した場合の影響は、どのクローラーを制限するかによって異なります。
特にアクセス数や検索流入を重視するWebサイトでは、学習への利用を制限することと、検索結果への表示を維持することを分けて判断する必要があります。
Google検索への影響
Googleは、Google-Extendedによる制御がGoogle検索の掲載やランキングに影響しないと説明しています。
ただし、Google-Extendedを拒否すると、Gemini関連サービスにおける一部の情報利用も制限されます。通常のGoogle検索を維持することと、Googleの生成AIサービスへの露出を維持することは同じではありません。
一方、Googlebot自体を拒否すると、Google検索におけるページの取得に影響します。
robots.txtでクロールを拒否しても、外部リンクなどからURLだけが検索結果に表示される場合がある点にも注意してください。
ChatGPT検索への影響
OpenAIは、学習関連のGPTBotと、ChatGPT検索で使用するOAI-SearchBotを区別しています。
そのため、GPTBotだけを拒否し、OAI-SearchBotを許可する構成が可能です。
ただし、OAI-SearchBotを許可しても、ChatGPT検索で必ず引用・紹介されるわけではありません。検索結果への採用には、コンテンツの関連性など別の要因も関係します。
また、ChatGPT-Userのように利用者の操作をきっかけとして動作する取得処理は、通常の自動クロールとは扱いが異なる場合があります。
Claude検索への影響
Anthropicは、ClaudeBot、Claude-SearchBot、Claude-Userの用途を公式に区別しています。
ClaudeBotのアクセスを制限すると、今後のコンテンツを学習データから除外する意思表示になります。
一方、Claude-SearchBotを制限すると検索関連の情報取得に、Claude-Userを制限すると利用者の要求による取得に影響する可能性があります。
検索経由の認知や送客を重視する場合は、必要以上に広い範囲を拒否しないことが重要です。
2026年10月発表のAI学習拒否の共通指定とは?
2026年10月30日、OpenAIは、Webサイト運営者が複数のAI事業者へ学習利用に関する意向を伝えられる共通の仕組みへの対応方針を発表しました。
これは、事業者ごとに異なるクローラー名を指定する管理負担を減らすための取り組みです。
新しい共通指定として提案されているのが、__usage_ai-trainingという識別子です。
共通指定を使った記述例
User-agent: __usage_ai-training
Disallow: /
この指定は、AI学習への利用を拒否する意思を、対応する事業者にまとめて伝えるためのものです。
ただし、2026年11月4日時点では、すべてのAI事業者が共通指定に対応済みというわけではありません。
OpenAIは今後数か月で実装する方針を発表しており、従来の個別クローラー制御も継続すると説明しています。
そのため、現時点では共通指定だけに依存せず、各社が案内している個別の拒否ルールを維持する方法が考えられます。
共通指定と個別指定を併用する例
新しい共通指定への対応を見据えつつ、既存の学習用クローラーも制限する場合は、次のような記述になります。
User-agent: __usage_ai-training
Disallow: /

User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /
これは複数の指定を組み合わせた設定例であり、すべてのAI事業者による学習利用を完全に防ぐものではありません。
また、Google-Extendedは通常のクローラーと異なる製品別の制御トークンであるため、一般的なrobots.txtのUser-agentと同じように扱えるとは限りません。実際の対応状況は各社の仕様に依存します。
共通指定の標準化や各社の実装状況は今後変更される可能性があります。
robots.txtでAI学習を拒否する際の注意点
すでに学習されたデータを削除できるわけではない
robots.txtは、主にクローラーによる今後のアクセスに対する指示です。
Anthropicも、ClaudeBotを制限した場合は今後のコンテンツを学習データから除外する意思表示になると説明しています。
過去に収集済みの情報や、別の経路で取得されたコンテンツまで削除できるわけではありません。
User-agent: *を安易に拒否しない
User-agent: *は、特定の名前で指定していないクローラーを広く対象にするための記述です。
例えば次の設定は、AI学習用だけを対象にしたものではありません。
User-agent: *
Disallow: /
この設定をサイト全体へ適用すると、Googlebotなどの一般的な検索クローラーのアクセスまで制限する可能性があります。
検索流入を維持したい場合は、拒否対象を個別に指定する方法を優先してください。
既存のrobots.txtを上書きしない
WordPressのrobots.txtには、管理画面やサイトマップに関係する設定が含まれている場合があります。
AI学習拒否のためにファイル全体を書き換えると、既存のクロール制御が失われる可能性があります。
新しい設定を追加する際は、既存ルールとの競合や同じUser-agentの重複を確認してください。変更後に問題が生じた場合は、バックアップから元の設定へ戻せるようにしておきましょう。
robots.txtだけでは無断収集を完全に防げない
robots.txtは、対応するクローラーが自主的に従う仕組みです。
設定を無視するクローラーや、別の経路で取得されるコンテンツまで完全に制御できるわけではありません。
より強いアクセス制御が必要な場合は、認証、サーバー側の制限、WAF(Webアプリケーションへの不正な通信を検知・制限する仕組み)などを目的に応じて組み合わせる必要があります。
ただし、IPアドレス単位の遮断や広範囲のBot対策は、正規の検索クローラーや利用者にも影響する場合があります。
AI学習は拒否したほうがよい?サイト運営者の判断基準
AI学習を拒否するべきかどうかは、サイトの収益構造やコンテンツの性質によって異なります。
| サイトの運営方針 | 検討したい設定 | 判断する理由 |
|---|---|---|
| 検索流入を重視する情報サイト | 学習用と検索用を分けて制御 | AI検索からの流入機会を残しやすくするため |
| 独自の有料コンテンツを扱うサイト | 学習拒否と認証による保護を併用 | 公開情報と非公開情報を区別するため |
| 企業の公式サイト | AI検索での露出も考慮して個別に判断 | ブランド認知や問い合わせへの影響を検討するため |
| 一般公開を重視するブログ | 学習拒否の必要性を個別に判断 | コンテンツの利用制限と情報の発見可能性を比較するため |
特に広告収益やアフィリエイト収益を得ているサイトでは、AI検索からのアクセスが収益につながる可能性もあります。
ただし、AI学習を許可すればアクセスが増える、拒否すれば収益が減るといった単純な関係が実証されているわけではありません。
学習利用への考え方と、検索経由の集客をどこまで維持したいかを分けて判断することが大切です。
まとめ:AI学習だけを拒否するならクローラーの用途を確認する
robots.txtを使えば、GPTBotやClaudeBotなどの学習関連クローラーに対して、Webサイトのコンテンツ収集を拒否する意思を伝えられます。
一方で、AI検索に使用されるクローラーまで拒否すると、検索結果での露出に影響する可能性があります。
2026年10月には共通指定への対応方針も発表されましたが、各社の実装が完了するまでは従来の個別指定も重要です。
設定する際は、既存のrobots.txtを保存し、学習用クローラーだけを対象にするか検討したうえで、変更後の公開ファイルを確認してください。
PR記事一覧
- 【ラインレンジャー攻略】2025年9月キャラガチャの性能解説|ガチャは引くべき?最強や当たりは誰?【LINE Rangers】
- 【ラインレンジャー攻略】ガチアクタコラボの当たりキャラ性能解説|ガチャは引くべき?最強は誰?【LINE Rangers】
- 【ラインレンジャー攻略】2025年11月キャラガチャの性能解説|ガチャは引くべき?最強や当たりは誰?【LINE Rangers】
- 【ラインレンジャー攻略】ガチアクタコラボの当たり武器や装備の最強性能解説|ガチャは引くべき?【LINE Rangers】
- 【ラインレンジャー攻略】スパイファミリーコラボの当たりキャラ性能解説|ガチャは引くべき?最強は誰?【LINE Rangers×SPY×FAMILY】
- 【APEX動画】笑ったら負けw デスボックスの珍事件が発生wwwww【エーペックスレジェンズ攻略】
- 保護中: 限定【ApexLegends】エイムアシスト自動チートツールのやり方(裏技導入方法)|PS4・PS5・Steam(PC版)・Switch対応【エーペックスレジェンズ攻略】
- 【APEX動画】最強チートを使わせるチートがヤバいと話題にwww【まとめ速報攻略】
- 【ApexLegends】エイムアシスト自動チートツールのやり方(裏技導入方法)|PS4・PS5・Steam(PC版)・Switch対応【エーペックスレジェンズ攻略】
- 【APEX】日本人がやめた理由ww【まとめ速報攻略】
- 【NIKKE(メガニケ)】ジュエルを無料でチート級に集める最強裏技方法|簡単に無課金で廃課金レベル!お得にお金を入手するやり方【勝利の女神NIKKE攻略】
- 【ポイ活】無料ゲームで稼げるポイントアプリ一覧(副業収益公開)|ソシャゲで効率的に稼ぐ簡単なやり方【初心者でも簡単に儲けるPRサイト】
- 【新規ゲーム】人気のおすすめソシャゲ一覧|リリースしたての面白いゲームまとめ【PR】
- 【モンハンNow】ジェムを無料でチート級に集める最強裏技方法|簡単に無課金で廃課金レベル!お得にお金を入手するやり方【モンスターハンターナウ攻略】
- 【モンハン最新情報】2025年に新作「モンハンワイルズ」が発売!2024年夏に続報
- 【バイオレクイエム】グレース女子高生の見た目MODの導入方法と使い方【バイオハザード9チート改造】
- 【バイオレクイエム】グレース全裸化エロMODの導入方法と使い方【バイオハザード9チート改造】
- 【バイオレクイエム】最強の無敵化MODの導入方法と使い方【バイオハザード9チート改造】
- 【バイオレクイエム】ボーナスコンテンツロック解除MODの導入方法と使い方【バイオハザード9チート改造】
- 【バイオレクイエム】グレース巨乳化エロMODの導入方法と使い方【バイオハザード9チート改造】
- 【バイオレクイエム】移動速度変更MODの導入方法と使い方|ゾンビの走る・歩くスピードを遅くする【バイオハザード9チート改造】
- 【バイオレクイエム】CPポイント無限化MODの導入方法と使い方【バイオハザード9チート改造】
- 【バイオレクイエム】アイテム無限化MODの導入方法と使い方【バイオハザード9チート改造】
- 【バイオレクイエム】おすすめの見た目変更エロMOD|衣装を変えるツール導入方法と使い方【バイオハザード9チート改造】
- 【バイオレクイエム】おすすめの見た目服装変更MOD|衣装を変えるツール導入方法と使い方【バイオハザード9チート改造】
- 【バイオレクイエム】弾丸(弾薬)無限化・リロード不要MODの導入方法と使い方【バイオハザード9チート改造】
- 【バイオレクイエムMOD】おすすめの最強武器・便利アイテム一覧|改造ツール導入方法と使い方【バイオRE4チート】
- 【バイオレクイエムMOD】REFramework(リフレームワーク)の使い方とダウンロード|アプデ後の起動とツール導入方法・入れ方【バイオハザード9チート改造】
- 【バイオレクイエムMOD】REFramework(リフレームワーク)の使い方とダウンロード|アプデ後の起動とツール導入方法・入れ方【バイオハザード9チート改造】
- 【バイオレクイエム】MOD管理ツール「Fluffy Manager」の導入方法と使い方|アプデ後に落ちるエラー時・稼働しない時の対策対処【バイオハザード9チート改造】
- 観葉植物の土からコバエが出る原因は?キノコバエの駆除・予防方法を徹底解説
- 観葉植物は秋に植え替えても大丈夫?9月・10月の適期と失敗しない判断基準
- 【アガベ実生】エボリスピナの種まき・育成・成長記録|育てるポイントや発芽しないときの対処方法【観葉植物・多肉植物】
- 【アガベチタノタ】人気の高い種類一覧(品種人気ランキング)|水やりや育て方【リュウゼツラン・観葉植物】
- 【アガベ】子株・カキコ・ベアルートの発根管理方法・発根率を上げる土耕栽培・水耕栽培・水苔栽培【観葉植物・多肉植物】
- 【アガベ】よくある病気・害虫一覧|症状や駆除対策方法(炭疽病・カイガラムシ・アザミウマ・アガベマイト(ダニ)・根腐れ・葉焼け)【観葉植物・多肉植物】
- 【アガベ】炭疽病になる原因・治療方法|おすすめの薬剤や治療方法・うつる対策方法【多肉植物・観葉植物】
- 【アガベ】オバケ・錦・中斑・外斑・全斑・覆輪とは? 特徴や出やすい品種|スナグルトゥースは育つのか【観葉植物・多肉植物】
- 【観葉植物】サボテン・アガベ・塊根植物の育成栽培に必要な道具一覧|虫対策の土・水やり・LEDライト・肥料・殺菌剤など【多肉植物】
- 【サボテン多肉植物】綴化・石化・モンストとは何?|違いや特徴・ 珍しい希少種になる原因【観葉植物・多肉植物】
- 【サボテン】台木や接ぎ木におすすめのサボテン一覧|穂木の成長速度や耐寒性の特徴・作業に必要な道具【観葉植物・多肉植物】
- 【サボテン種まき】種から育てる方法|種子の発芽率を上げる育て方・適正気温やカビ対策【実生】
- 【観葉植物】プレステラ鉢のサイズ比較|90・105・120・深鉢など大きさの種類一覧【アガベ・サボテン・塊根・多肉植物】
- 【アガベ】メリクロン株とは?組織培養のやり方やデメリット|メリクローン苗の育て方【リュウゼツラン・観葉植物・多肉植物】
- 【アガベ】黒獄(長棘ハデス・恐竜歯牙・黒帝斯)|育てる時の注意ポイントやおすすめの育て方【チタノタ・観葉植物・多肉植物】
- 【アガベ】魔丸の育成・成長記録|育てる時の注意ポイントやおすすめの育て方【チタノタ・観葉植物・多肉植物】
- 【アガベチタノタ】冰雹の育て方や増やし方|ブツブツ系・スタッズタイプの水やり・適正気温・種まき【リュウゼツラン・観葉植物・多肉植物】
- 【アガベチタノタ】鰐亀の育て方や増やし方|ブツブツ系・スタッズタイプの水やり・適正気温・種まき【リュウゼツラン・観葉植物・多肉植物】
- 【アガベチタノタ】星空の育て方や増やし方|ブツブツ系・スタッズタイプの水やり・適正気温・種まき【リュウゼツラン・観葉植物・多肉植物】
- 【アガベチタノタ】流星の育て方や増やし方|ブツブツ系・スタッズタイプの水やり・適正気温・種まき【リュウゼツラン・観葉植物・多肉植物】
- 【アガベチタノタ】痘痘龍(豆豆龍)の育て方や増やし方|ブツブツ系・スタッズタイプの水やり・適正気温・種まき【リュウゼツラン・観葉植物・多肉植物】
- 【アガベチタノタ】麻花龍の育て方や増やし方|ブツブツ系・スタッズタイプの水やり・適正気温・種まき【リュウゼツラン・観葉植物・多肉植物】
- 【アガベチタノタ】ブラックダイヤモンド(ブルーダイヤモンド・BB錦・BD・ブルーボール黄覆輪)の育て方や増やし方|水やり・適正気温・種まき【リュウゼツラン・観葉植物・多肉植物】
- 【アガベ】皇冠(クラウン)の育成・成長記録|育てる時の注意ポイントやおすすめの育て方【チタノタ・観葉植物・多肉植物】
- 【アガベチタノタ】皇冠(クラウン)の育て方や増やし方|水やり・適正気温・種まき【リュウゼツラン・観葉植物・多肉植物】
- 【アガベチタノタ】阿修羅(アシュラ)の育て方や増やし方|水やり・適正気温・種まき【リュウゼツラン・観葉植物・多肉植物】
- 【アガベチタノタ】金蟾(金蟾王)の育て方や増やし方|水やり・適正気温・種まき【リュウゼツラン・観葉植物・多肉植物】
- 【アガベ】阿修羅の育成・成長記録(シマムラ園芸で購入)|育てる時の注意ポイントやおすすめの育て方【チタノタ・観葉植物・多肉植物】
- 【アガベ】金蟾 (金蟾王)の育成・成長記録(シマムラ園芸で購入)|育てる時の注意ポイントやおすすめの育て方【チタノタ・観葉植物・多肉植物】
- 【シマムラ園芸】2024年2月23日「草乱祭イベント」に行ってみた!会場の様子や雰囲気レビュー【観葉植物・多肉植物・アガベ・サボテン・ビカクシダ・塊根】
- 【動画あり】このロシア美女のフ○ラチオ、凄すぎると話題に
- 【画像】一流女子アスリートのマン筋・モリマン・ピン立ち乳首がエロ過ぎるwww
- 【朗報】ワンピースのアニメで乳首解禁、ナミやヤマトのデカ乳が丸見えwww(動画あり)
- 【動画あり】男女混合のレスリング大会の試合風景がほぼセックスだと話題にwww
- 【動画あり】センペロ居酒屋で働く女さん、美人でサービス良くてSNSで大バズりwwwww
- 【動画】あたシコ超爆乳外国人さん、公共の場所でデカ乳をボロンと出してしまうwww
- 【画像・GIF】海外のビーチに現れたJKさん、とんでもない爆乳を晒して男性全員を勃起させるwww
- 【画像】土下座コスプレイヤーさんドスケベすぎるwwwww
- 【画像あり】ロシアに行って女を抱いてきた。8500円の風俗で出てきたキャストがコレwww
- あたし剛毛女(25)、彼氏との性行為中にクリを舐めさせた結果wwwwww
- 【人気媚薬】効果がある「びやく(惚れ薬)」おすすめランキング|性欲を高める催淫剤の通販サイトまとめ
- 【女性向け大人のおもちゃ】おっぱい(バスト・胸)やマンコおすすめ吸引ポンプ器具人気ランキング【女性器を大きくする方法】
- 【ペニス増大】おすすめの吸引ポンプ器具人気ランキング|亀頭やちんこを大きくする方法【男性性器増強】
- 【ペニス増大】おすすめのサプリメント人気ランキング10選|亀頭やちんこを大きくする方法【男性用精力・性器増強剤】
- 【サンブレイク】見た目を「巨大乳輪ムチムチ体型」にするエロMODの導入方法と入れ方【モンハンライズ(MHRise)チート改造】
- 【サンブレイク】ロンディーネ見た目を「超爆乳全裸」にするエロMODの導入方法と入れ方【モンハンライズ(MHRise)チート改造】
- 【サンブレイク】見た目を爆乳ムチムチ水着に変えるエロMODの導入方法と入れ方【モンハンライズ(MHRise)チート改造】
- 【サンブレイク】全裸ルーチカをエルガドのベッドに寝かせるエロMODの導入方法と入れ方【モンハンライズ(MHRise)チート改造】
- 【サンブレイク】超爆乳セイラー装備の見た目にするエロMODの導入方法と入れ方【モンハンライズ(MHRise)チート改造】
- 【モンハンライズ】見た目を乳◯が出ているスケスケレースバニーにするエロMOD導入方法【MHRiseチート改造】
- 【MHWI】ほぼ全裸のエロい見た目装備で「火を吹くイヴェルカーナ」の改造モンスター討伐|Part417【モンハンワールドアイスボーン】
- 【サンブレイク】起動画面をエロい「フィオレーネ・ヒノエ・ミノト」にする見た目MODの導入方法と入れ方【モンハンライズ(MHRise)チート改造】
- 【サンブレイク】インナーの見た目を全裸や水着に変えるエロMODの導入方法と入れ方【モンハンライズ(MHRise)チート改造】
- 【エルデンリング】キャラを「全裸の見た目」に変更するエロ装備MODの導入方法と入れ方|Part2【ELDENRING】
- 【サンブレイク】ハンターの見た目をおっぱい丸出しメイドに変更するエロMODの導入方法と入れ方【モンハンライズ(MHRise)チート改造】
- 【サンブレイク】人気のおすすめ最新MOD一覧21~40|簡単チート導入・便利ツール入れ方と使い方【モンハンライズ(MHRise)改造】
- 【モンハンライズ】受付嬢「ヒノエ・ミノト」を全裸の見た目にするエロMODの導入方法|P43【MHRiseチート改造】
- 【サンブレイク】人気のおすすめ最新MOD一覧1~20|簡単チート導入・便利ツール入れ方と使い方【モンハンライズ(MHRise)改造】
- 【MHWI】おすすめの擬人化エロMOD(装備の見た目変更)|ケモナーに人気の最新衣装まとめ【モンハンワールドアイスボーン】
- 【MHWI】見た目をエロ装備にするおすすめMOD一覧|全裸でお◯ぱいや陰毛丸出しのR18禁ヌード衣装の画像付き!2023年最新版【モンハンワールドアイスボーン】